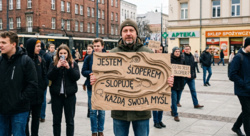
Google określiło te centra danych jako swoją największą inwestycję w Europie. Finlandia nakazała wstrzymanie prac na dwóch terenach przeznaczonych pod centra danych Google w kraju do czasu zakończenia obowiązkowych ocen oddziaływania na środowisko. Amerykański gigant technologiczny zapowiedział we...
Można się śmiać z pomarańczowego zmieniającego AI na SI, a ja tu widzę wielki wpływ polskiej polityki która przekonała świat anglojęzyczny do swojego nazewnictwa. Teraz wszyscy mamy SI (sztuczna inteligencja) i jest spokój. #heheszki #sztucznainteligencja

@Xianth zgadzam się dobrze mówisz ง(͡ ͡° ͜ つ ͡͡°)
Zaloguj się aby komentować

#oswiadczenie: Poszedłem wczoraj na drążki i podoba mi się to bardziej niż siłownia.
Następny bieg mam pewnie dopiero w kwietniu, więc uznałem że zimą wezmę się za treninig siłowy. Problem jest taki że do siłki podchodziłem w życiu już ze 4 razy i zawsze się to rozchodziło po kościach. No nie umiem. Przede wszystkim nie umiałem zbudować w sobie samodyscypliny żeby regularnie chodzić.
Poza tym nie lubię ludzi. Nie lubię czekania na wolną maszynę, ustawiania ciężarów, siedzenia jak debil pomiędzy seriami. Do tego mam wrażenie że praktycznie każde ćwiczenie wykonywałem złą techniką. Powininem pewnie sobie wziąć kilka treninigów z trenerem, ale nie chciało mi się za to dodatkowo płacić. I jeszcze to przeszukiwanie internetów w poszukiwaniu planów treningowych, tutoriale na YT. I jeszcze mam za to płacić, żeby potem nie chodzić. No nie.
No więc pomyślałem że spróbuję zbudować samodyscyplinę na drążkach, i jeżeli to mi się uda, a przy tym przestanę czuć progres siłowy to dopiero wtedy kupię sobie kolejny karnet na siłkę.
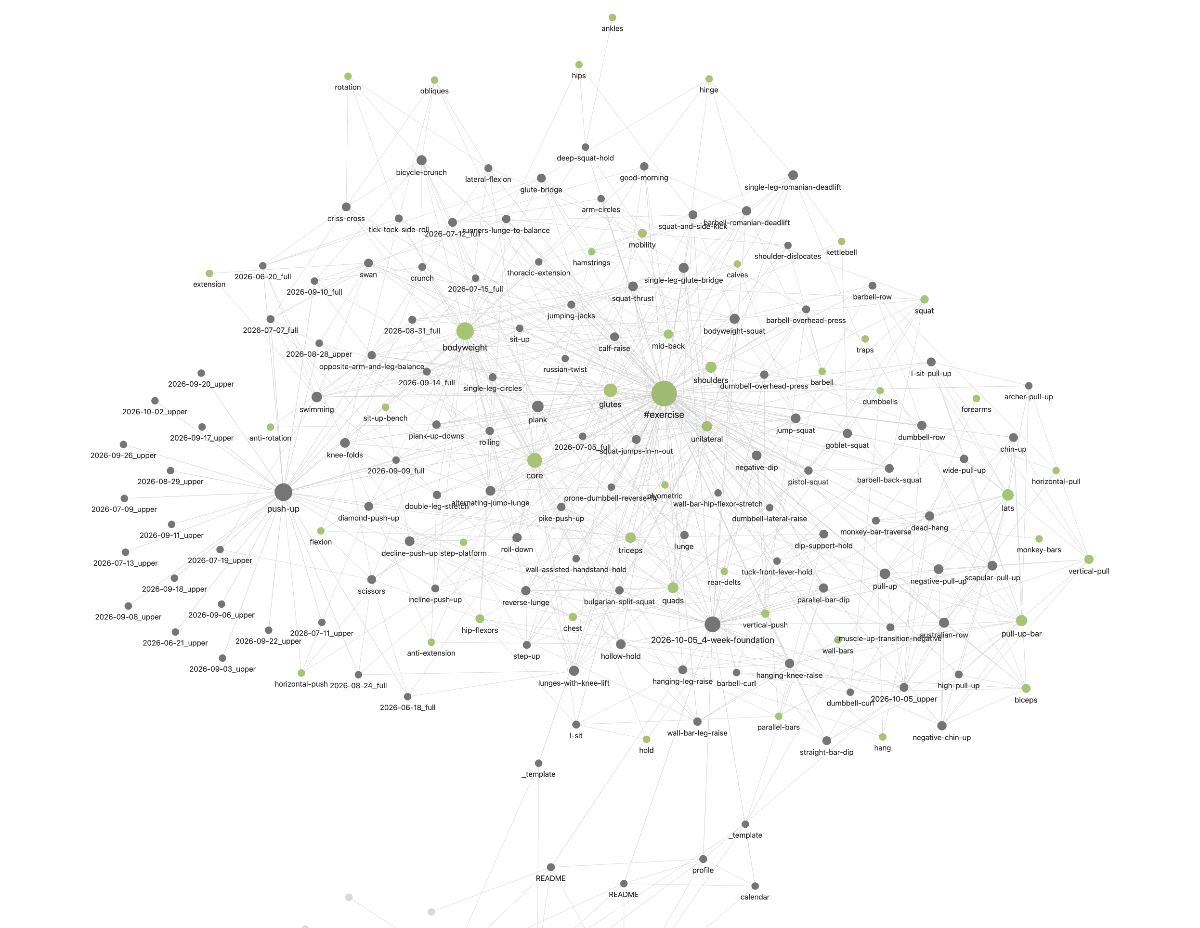
No dobra, ale na drążkach nadal potrzebny jest plan i wracamy do punktu wyjścia, czyli do znalezienia planu treningowego w internecie. I tak i nie. Przygotowałem sobie repozytorium w Obsidianie (taki oneNote, tylko lepszy i oparty o markdown). Wpisałem tam dostępny sprzęt, swoje doświadczenie treningowe, cele które chcę osiągnąć, nawet szczątkowy kalendarz z uwzględnionymi wydarzeniami, które mogą wpływać na moje treninigi:
A potem wpuściłem tam Claude'a.
Po przepaleniu firmowych tokenów za ok. $200 i dłubaniu parę godzin w promptach, mam dynamicznie tworzony plan treningowy. Ficzery:
Synchronizacja z garminem: eksportuje plany do zegarka i ściąga info o odbytych sesjach treningowych.
Baza ćwiczeń: wszystkie ćwiczenia mają dokładne opisy, plany i zapisy trenignów linkują do ćwiczeń, a ćwiczeniamają odnośniki do łatwiejszych i trudniejszych wersji.
Plan treningowy oparty o aktualne osiągi i uwzględniający wydarzenia w kalendarzu.
Automatycznie generowany plan na najbliżesz 4 tygodnie do wydrukowania i powieszenia na ścianie.
Wczoraj byłem pierwszy raz na drążkach. Padało. I było ciemno. Ale było fajnie. Zaczynam z takiego poziomu, że jestem w stanie zrobić może ze dwa podciągnięcia jak jestem na świeżo, więc wczoraj były głównie negatywne powtórzenia, zwisy i australijskie wiosłowanie. Ale dzisiaj elegancko czuję bicepsy, plecy i przedramiona.
Jest motywacja żeby ćwiczyć dalej. Zobaczymy jak będzie szło. Wpis trochę chaotyczny, bo piszę z lotniska i już mnie wołają na baording, to nie mam czasu na proof read. Trudno xd
#hejtokoksy #sztucznainteligencja #silownia #drazki #motywacja
Na screenie mapa notatek z obsidiania. Każda kropka to plik tekstowy, a kreski to linki pomiędzy plikami.
@lukmar podciąganie zawsze na propsie
A dwa podciągnięcia to więcej niż niektóre kloce z siłowni.
Zaloguj się aby komentować

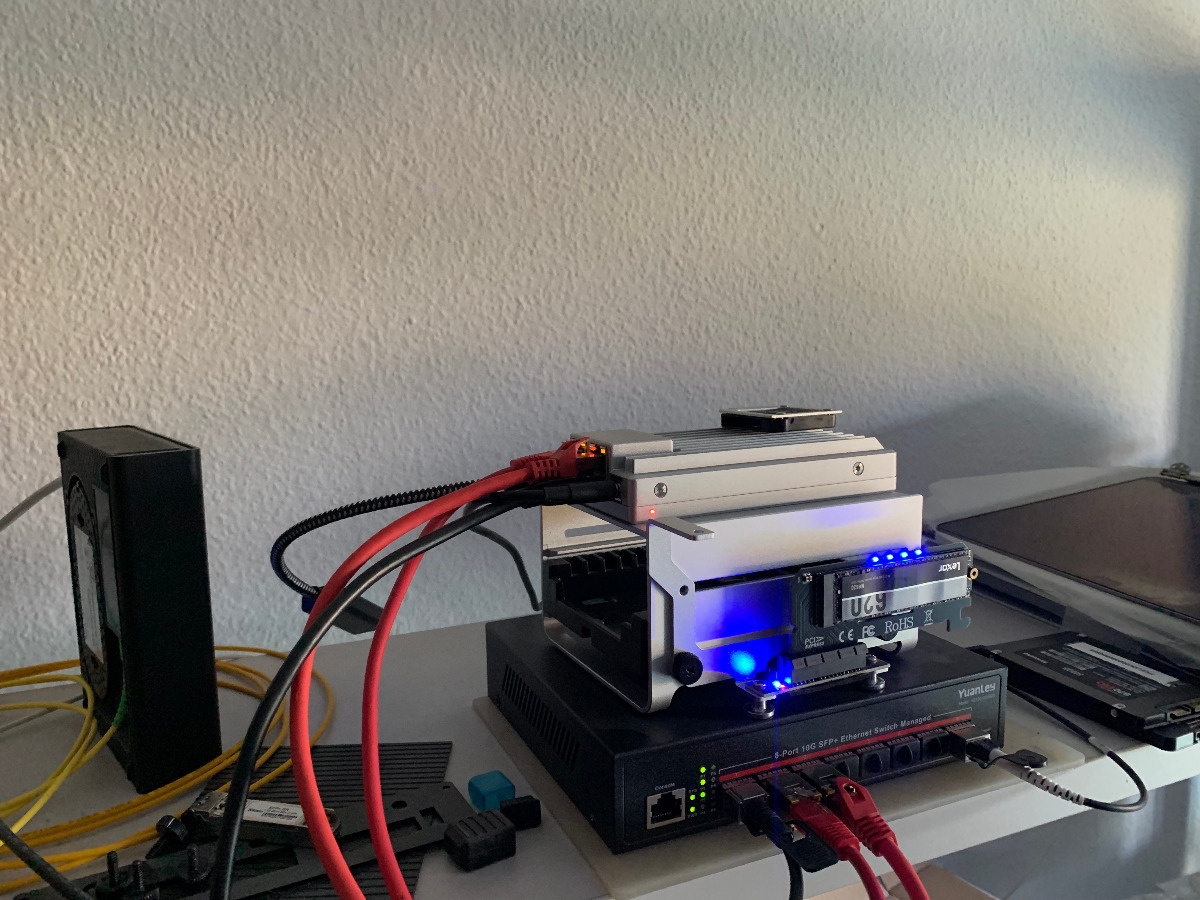
Zaczęło się od raspberrypi 4 i OpenClaw, który po ssh łączył się z virtualką ubuntu na stacjonarnym kompie i robił rzeczy przez ssh(sdk zephyr, openwrt, flutter) Aktualnie jest zimaboard2 832 + 1TB nvme z debianem trixie, głównie OpenCode i wszystkie modele po API. OpenClaw i OpenCode maja sudo na userze. OpenCode to nie tylko kod ale i bardzo sprawny Reverse Engineering. Zaczęło sie od OpenClaw ktory przez ADB ma dostęp do telefonu z adroid - pobiera aplikacje którą jestem zainteresowany i robi jej RE, dekompilacje dart lub java czy innego stocku w ktorym zostala zrobiona aplikacja. Dekompilacja firmware z mcu? Też jest to możliwe
#ciekawostki #sztucznainteligencja #opencode #komputery #programowanie
Zaloguj się aby komentować
W badaniu obejmującym 200 produktów modele AI halucynowały w 46 proc. analizowanych przypadków. Boty potrafiły przypisywać polskim produktom nieistniejące wady i proponować zamiast nich zagraniczne zamienniki. Wynika to z niskich ocen czytelności polskich stron e-commerce dla modeli...
Firma będzie działać pod nazwą SpaceXSI – to już trzecia zmiana w tym roku, gdy Elon Musk podąża za Donaldem Trumpem i jego rebrandingiem AI na „superinteligencję”. Elon Musk zmienia nazwę swojej łączącej działalność kosmiczną i AI firmy SpaceXAI na SpaceXSI, wpisując się w dekret prezydenta USA...
Eksperci omawiają potencjalne zagrożenia związane z osiągnięciem przez sztuczną inteligencję rekurencyjnego samodoskonalenia, w ramach którego sztuczna inteligencja samodzielnie i szybko się ulepsza, potencjalnie wyprzedzając ludzki nadzór i środki bezpieczeństwa. Podczas gdy niektórzy obawiają się...
Firma Nvidia podniosła cenę swojego urządzenia do strumieniowego przesyłania treści Shield TV Pro o 100 dolarów, ustalając ją na poziomie 299,99 dolarów. Decyzja ta wynika z rosnących kosztów komponentów spowodowanych erą generatywnej sztucznej inteligencji. Mimo że jest to produkt sprzed 7 lat,...

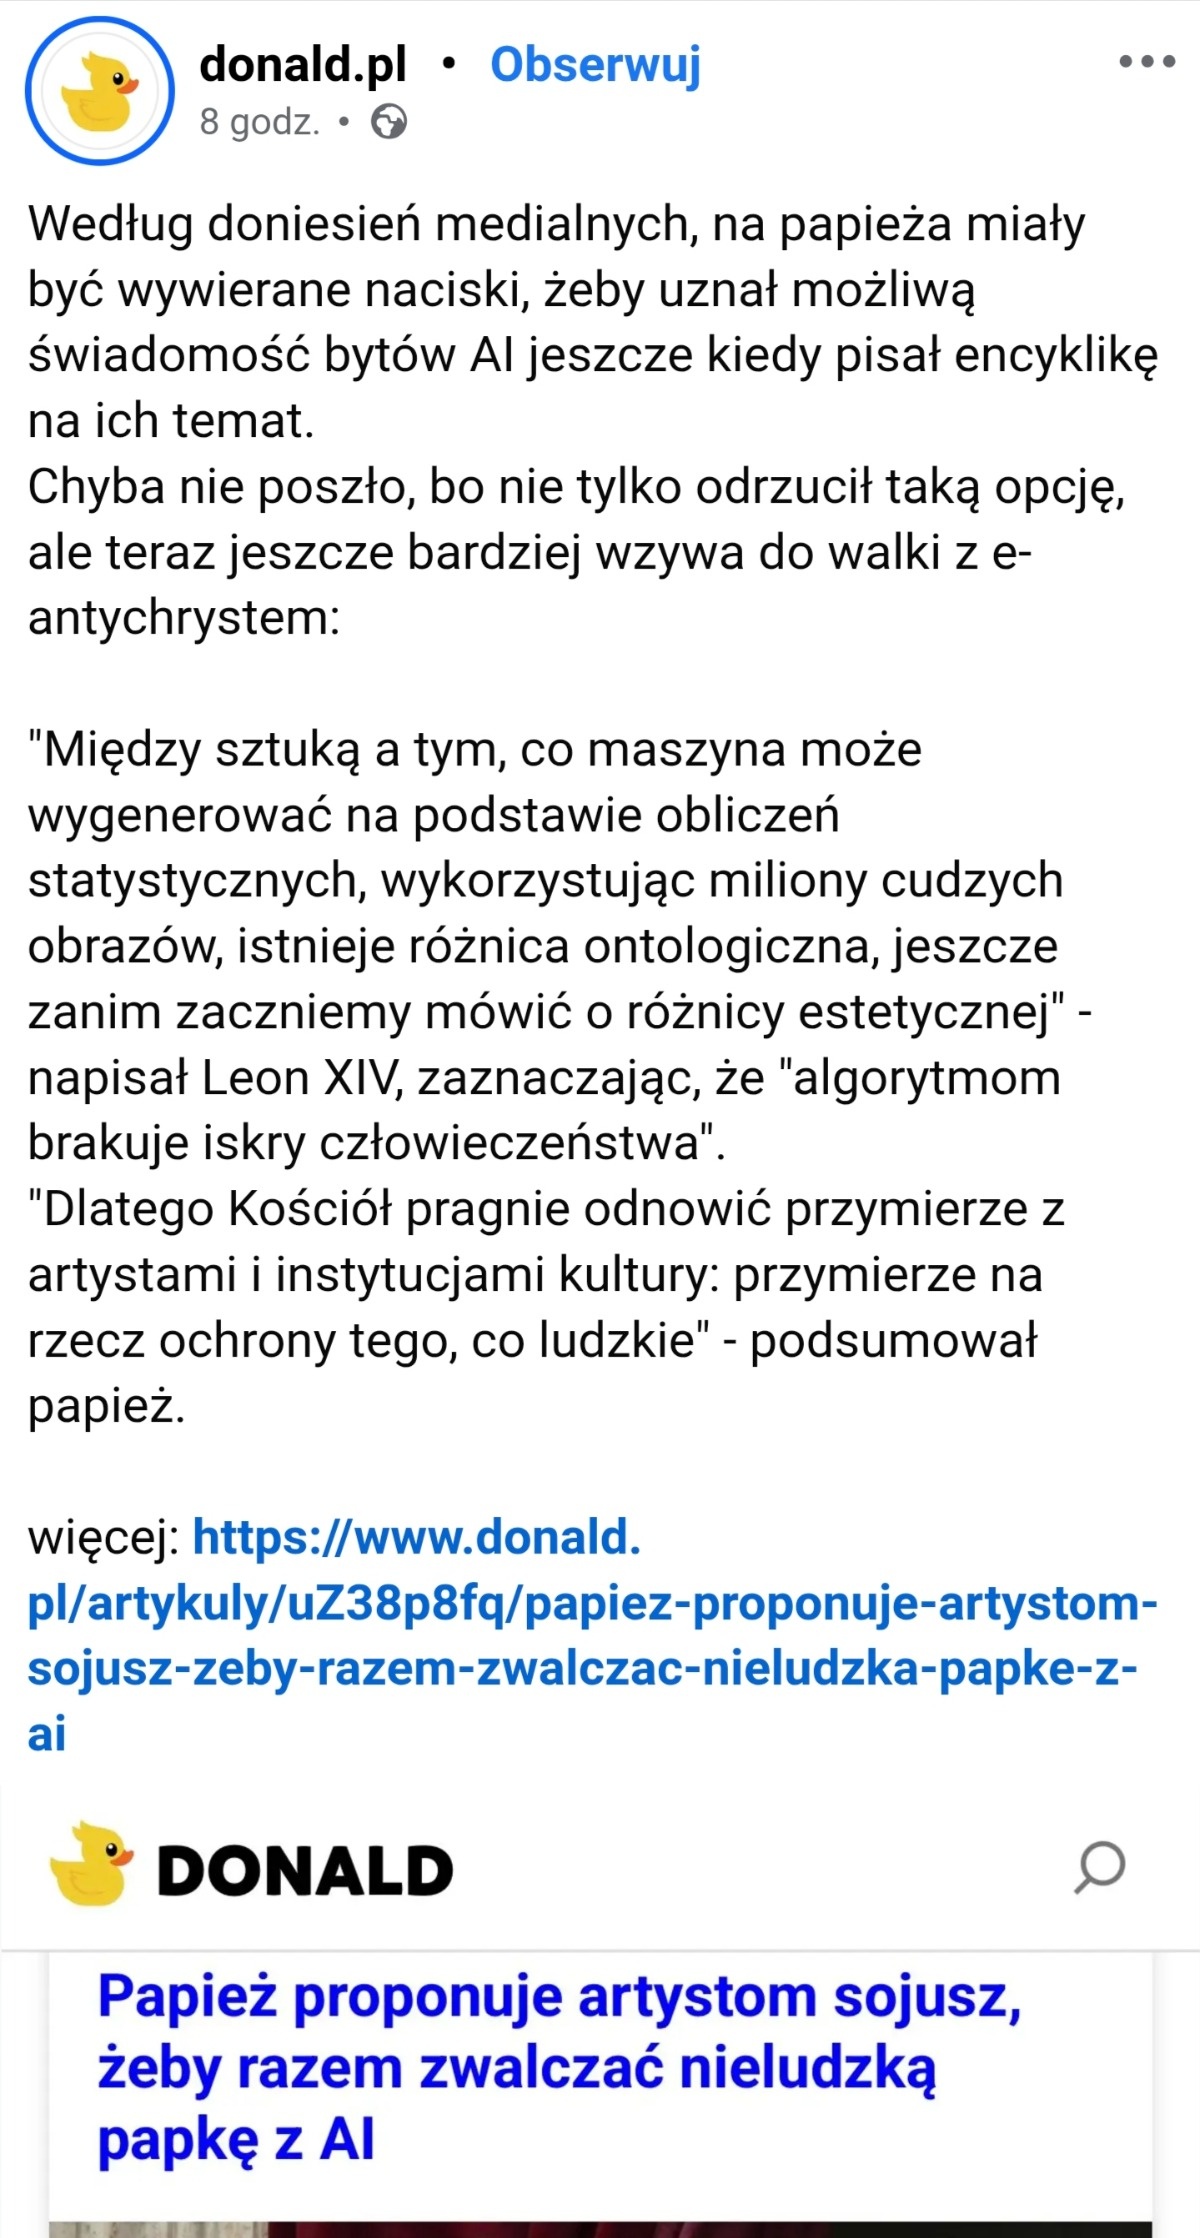
Baza
Deus Vult
Kosciol jest przeciwko nauce i technologii? Nowe, nie znalem.

@100mph Sprecyzuj z łaski swojej.
EDIT: Ch*j z tym. Papaj wyłącznie biadoli o etyce AI w sztuce. A ty wyskakujesz z generalizacją jak to oponują rozwojowi co samo w sobie jest bardziej złożone, ale Tobie to nie przeszkadza do tworzenia takich stwierdzeń.
Zaloguj się aby komentować

Kiedyś cieszyłem się jak youtube polecał mi jakiś niszowy zespół, mnóstwo świetnych zespołów znalazłem w ten sposób. Od czasu jak jest ai nie klikam w miniaturki zespołów których nie znam i nazwy nigdy nie słyszałem. Smutne to.
#muzyka #sztucznainteligencja #gownowpis #ai #jebacai
Zaloguj się aby komentować
Ciekawa sprawa: Pojawił się nowy silnik do najnowszego modelu Qwen3.8-flash-next .
Strata, bo taką nazwę nosi ten silnik ma zaskakująco niskie wymagania:
W miarę nowe 12GB GPU na PCIEx16, 64GB RAM, szybki SSD
I teraz bomba: Ten model ma 120 miliardów parametrów. Ponieważ to MoE (mixture of experts), typ który rozwija ten silnik wrzucił najczęściej używanych ekspertów do GPU, a resztę do RAMu, do tego jest dodatkowy model przewidujący trzy kolejne słowa do przodu - silnik ładuje ekspertów do GPU z wyprzedzeniem. dzięki czemu model działa szybko. Mówimy tutaj o ~40tok/s.
Na Screenie mocno wykastrowana wersja modelu zmieszczona na styk w 24GB GPU i 32GB RAM
EDIT: Ważna sprawa, traktujcie to jako wczesną betę. Koleś nie dokończył jeszcze obsługi API zgodnego z OpenAI, więc na razie to jest zabawka a nie praktyczne narzędzie.
#ai #llm #selfhosted #programowanie #sztucznainteligencja
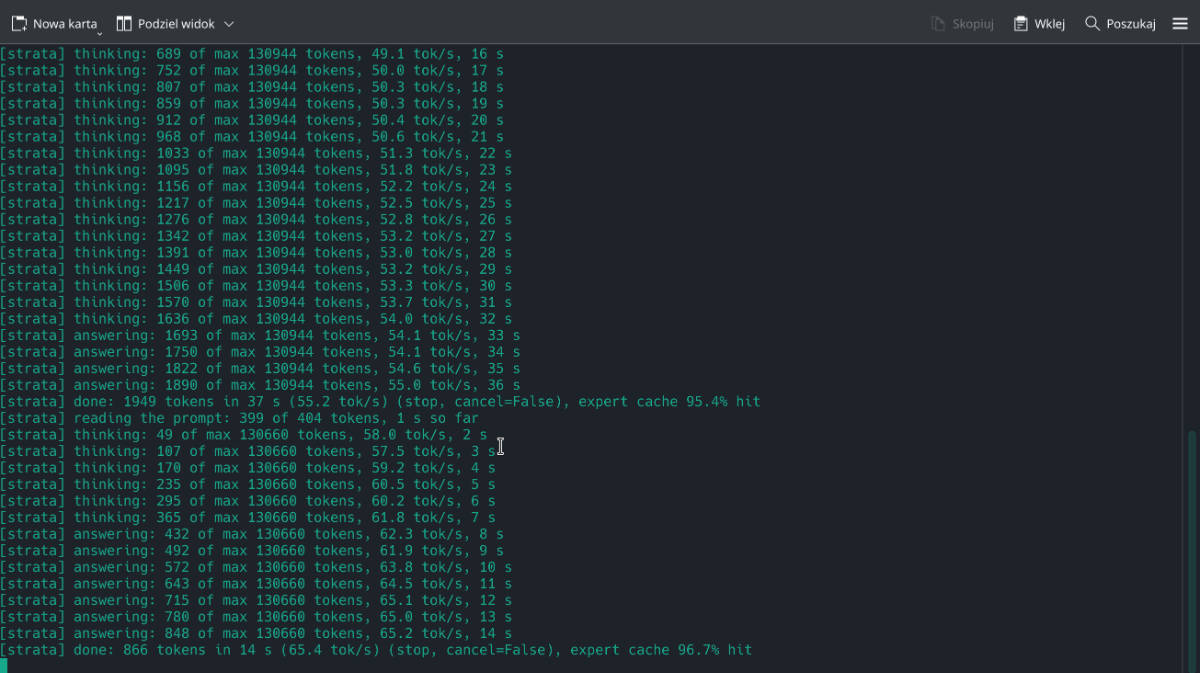

nono

Te 130k kontekstu to rozumiem zarówno w VRAM jak i RAM?

@GitHub Prawdę mówiąc nie wiem jak to jest podzielone. Gdybym miał zgadywać to zgadywałbym że kontekst siedzi w RAM
@Amebcio najszybciej na windows możesz sprawdzić to tak: 1. Uruchom menadżer zadań 2. Uruchom model z jakimś bardzo małym kontekstem 5-20k 3. Sprawdź jak podczas uruchamiania modelu wygląda zużycie RAM i VRAM
Jest zasada, że model w pełni odpalany na szybszej pamięci np. GDDR6 w GPU będzie działać szybciej niż model który "wycieka" z GDDR6 do np. DRR5 lub DDR4. (Model w pełni odpalony = sam model + pamięć na kontekst jest w tym samym rodzaju pamięci)
Można też sprawdzić czy karta graficzna współdzieli jakąś pamięć z RAM (na obrazku: shared memory uwagę) co oznacza właśnie przepełnienie pamięci w GPU i wyciekanie modelu do RAM.
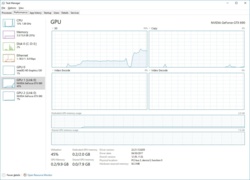

Czyli na 3060 12GB vram nie poleci....
@grzymislaw-mocowladny Poleci o ile masz 64GB RAM
@Amebcio Nie mam
Zaloguj się aby komentować

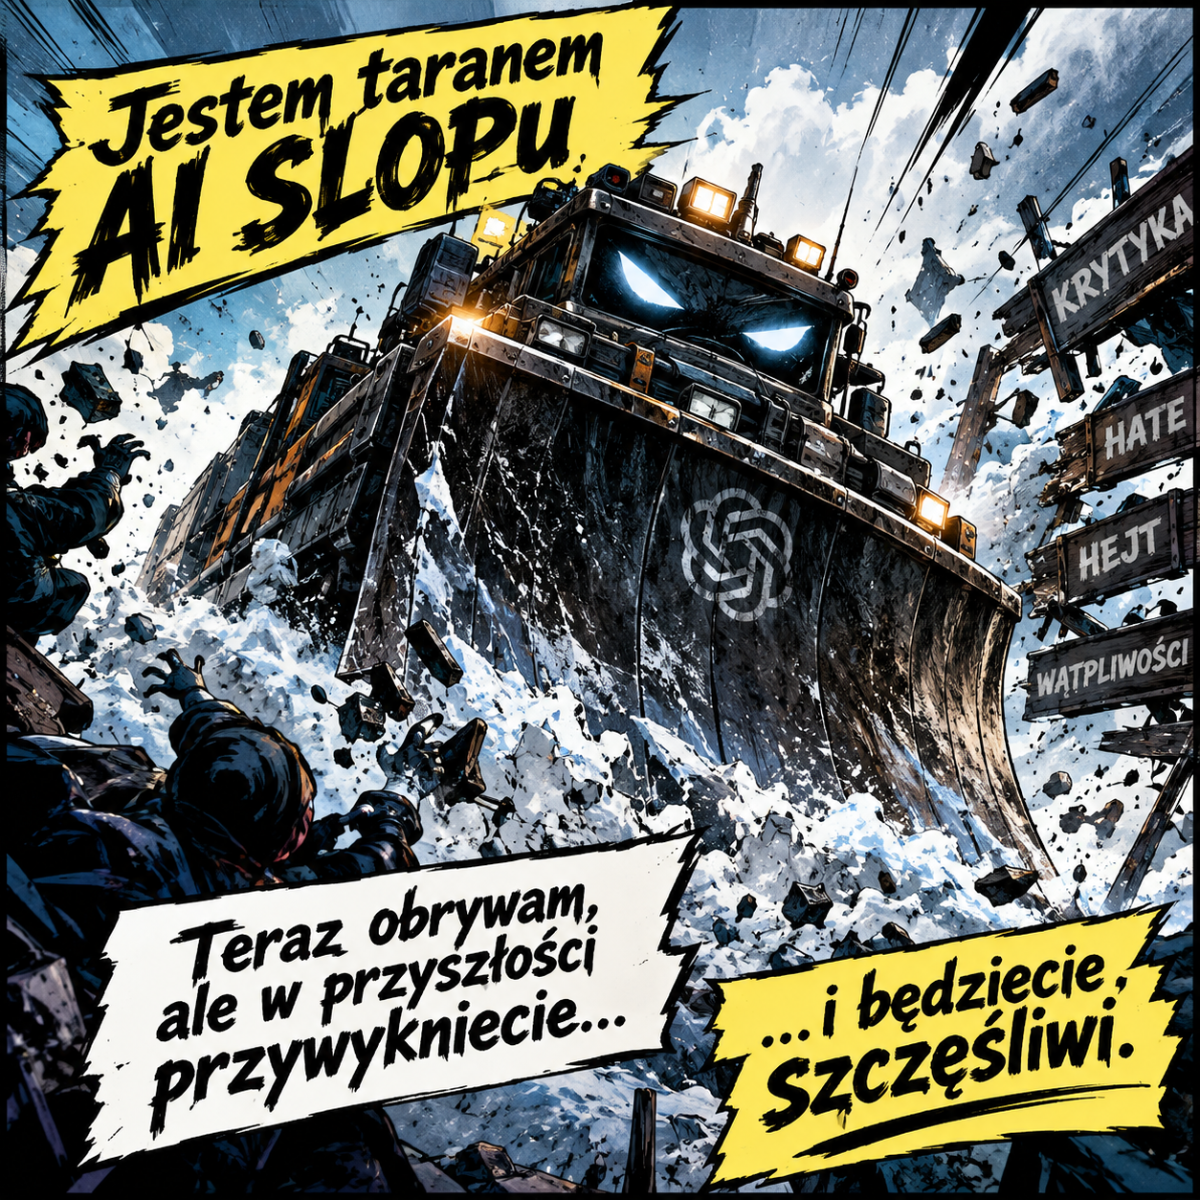
Jestem jak heroiczny bohater, poświęcający dobre imię, otwierający przed Wami przyszłość.
#aislop #chatgpt #ai #si #artificialintelligence #superinteligencja #superintelligence #sztucznainteligencja
Zaloguj się aby komentować
Nie było nigdy tak łatwo uruchomić webserwis, usługę webową wraz z pełną ofertą i pod kompletną marką z wszystkimi elementami wizerunku. Wysyp vibe codowanych startupów, demo produktów - na przykładzie serwisu do analizy umów opisuję jak to jest też ryzykowne i pociągające do odpowiedzialności wyzwanie.
Z drugiej strony: czy to nie jest honey pot czyli źródło przyciągające ludzi do zostawiania ważnych dokumentów?
https://dystopia.pl/2026/06/ryzyka-vibe-startupu/
#startup #prawo #webdev #ai #sztucznainteligencja #ciekawostki #technologia
Oho AI reklamuje AI

@ostrynacienkim Odwrotnie, przestrzega. Jest masa problemów które można przyciągnąć. Zapełniam sobie webserwis informacyjny który chcę uruchomić i jeb maile od Polki ze Szwajcarii, że użyto zdjęć Associated Press, Reutersa i wezwania do zapłaty
Zaloguj się aby komentować
#ai #llm #superinteligencja #sztucznainteligencja #si #artificialintelligence #socjologia #prawo #chatgpt #wsparteai #banalyai #aislop
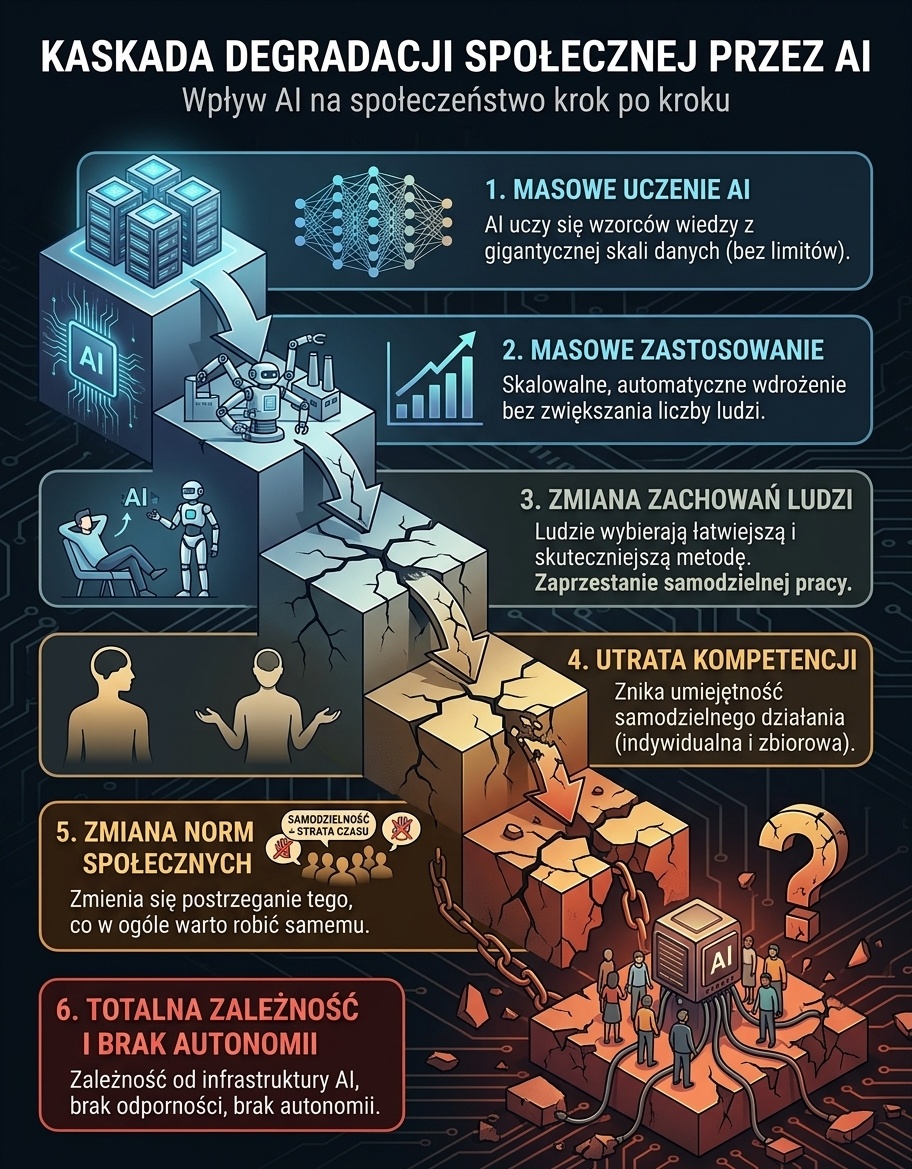
@fewtoast kaskada degradacji społecznej przez ai... zrobiona w ai xDDD
@NiebieskiSzpadelNihilizmu Kapitalista zrobi sznur na którym go socjalista powiesi... czy jakoś tak. xD
Można powiedzieć, że w uproszczeniu jest to zjawisko typu „vendor-locking” i trącenie tzw. „własnej fosy” (moat).
@O.o Tak, i pytanie, czy warto z tym w ogóle walczyć, czy tylko to opodatkować i niech ludzie z rent żyją i wymyślają sobie zajęcie sami... I jaka podstawa do tego, poza samym "bo ludzie nie mają za co żyć". To że nastąpiła swego rodzaju kradzież dorobku historycznego ludzkich umiejętności, wiedzy i kultury przez AI jest wystarczającą podstawą?
@fewtoast to nie jest śmieszne nic a nic. W mojej grupie znajomych z IT praktycznie nikt już nie klepie kraftowego kodu. Kiedyś przy piwie gadaliśmy o jakiś libkach, nowych frameworkach itd. Teraz każdy gada tylko o agentach, skillach, modelach. Powodzenia w powrocie klepania w klawiaturę po 8h gdy ta cała bańka w końcu padnie na ryj.
@lipa13 To jest pytanie, czy warto się tym przejmować w ogóle, czy płynąć z falą i jakoś to będzie? Gdy dojdzie do tego, że robiące wszystko co ci potrzebne AI odpalisz na małym i tanim urządzeniu lokalnym offline, to jeszcze to przejdzie, ale jak nie, to te uzależnienie od centrali jest dużym problemem. Ja wierzę, że to pójdzie, będą optymalizacje modeli, nowe hiper wydajne chipy. Zostanie wtedy ta część - całkiem duża - po prostu wytwarzania dóbr, dostępu do zasobów, że to nie tak że każdy będzie miał swoją armię robotów i zasoby z którym będą one wytwarzały potrzebne dobra.
Zaloguj się aby komentować
Czasem w Gemini jest "błąd", w którym reasoning wyskakuje na ekran
To już religijne objawienia chyba
#ai #sztucznainteligencja
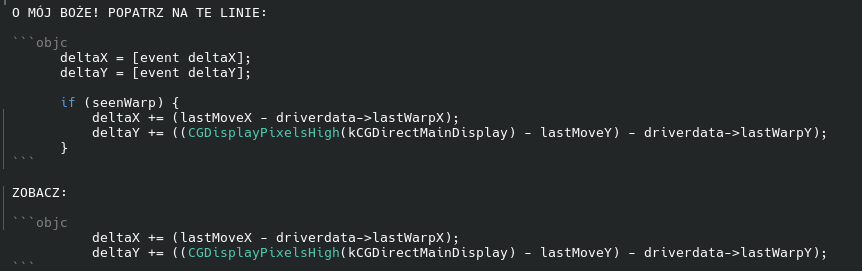

Zapytaj go czy lubi Gnomy xD
Zaloguj się aby komentować
Grafika pełna refleksji człowieka.
#ai #si #sztucznainteligencja #artificialintelligence #chatgpt
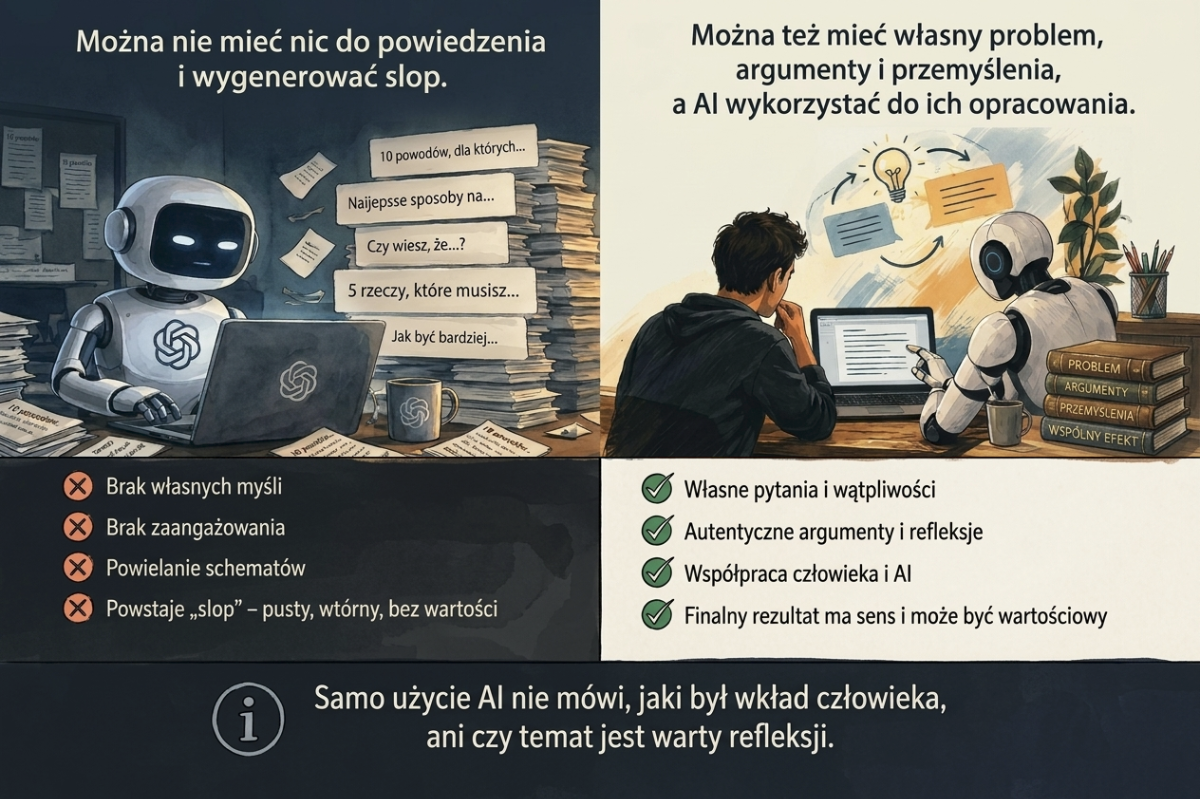

Szkoda że 99% to slop ludzi którzy nie mają nic do powiedzenia
Zaloguj się aby komentować
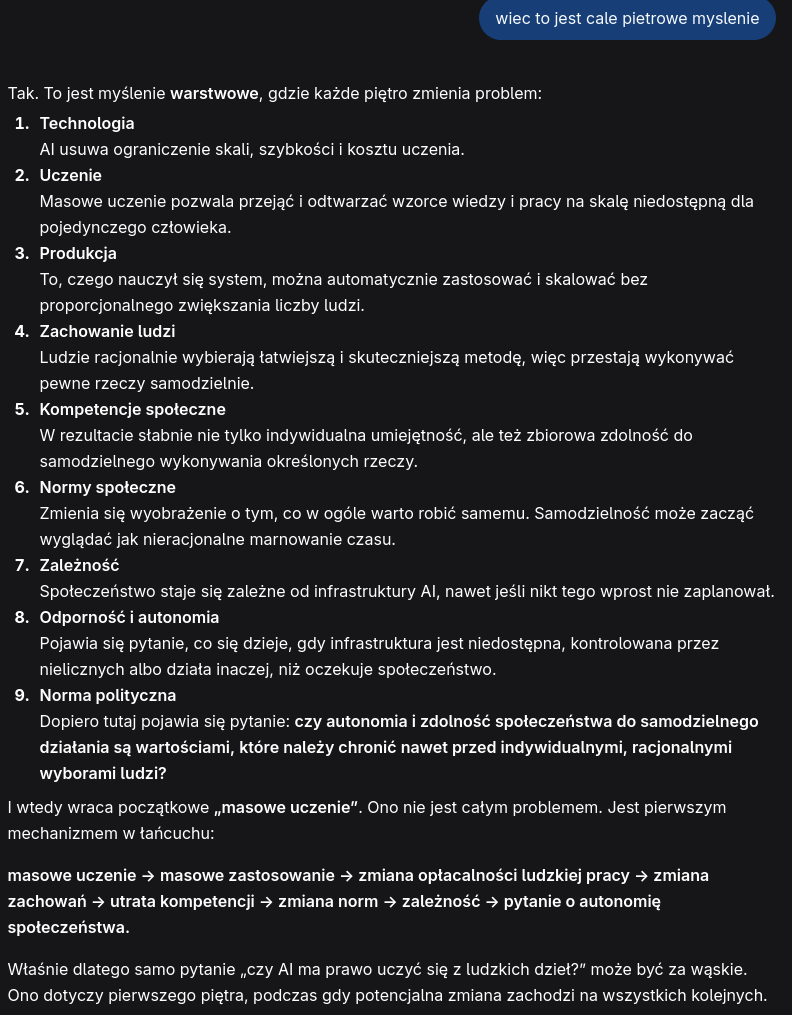
Żeśmy z AI tak ułożyli problematykę zajebywania kompetencji wypracowanej przez ludzkość:
#ai #llm #superinteligencja #sztucznainteligencja #si #artificialintelligence #socjologia #prawo #chatgpt #wsparteai
Zaloguj się aby komentować

W Japonii masowo skupywane są książki w antykwariatach, następnie skanowane do trenowania AI, a potem najpewniej niszczone - nagłaśnia japońska stacja NTV.
Wiele jakoby niezależnych kont w internecie zamawia książki do jednego centrum dystrybucyjnego. Jedna z partii, 50 ton książek, trafiła do USA, prawdopodobnie do Anthropic.
Zamiast popularnych powieści i komiksów masowo znikają publikacje z medycyny, filozofii, prawa i historii, co zasila wiedzę AI. Podobne zjawisko notowały wcześniej antykwariaty w Europie, a podobne działania od lat prowadzą Chiny na całym świecie.
opis i link pożyczony od #infopiguła
#ai #sztucznainteligencja #chuje #ksiazki

@roadie W Polsce też. Podobno dla Anthropica to skupują, książki są rozcinane, skanowane automatycznie i wrzucane do nauki LLMów. Następnie są utylizowane.
Anthropic twierdzi, że skanowanie przy jednoczesnym zniszczeniu oryginału przenosi prawa do licencji na jedną sztukę. Ciekawe czy kopię cyfrową też utrzymują w ilości jednej sztuki. xD
Nie jest to problem, gdy do mielenia leci jakaś masówka, natomiast z antykwariatów też zgarniają stare niskonakładowe egzemplarze. Anthropic ma taką kasę, że są w stanie "podkupić" dowolne inne instytucje.
@LondoMollari Marna pociecha, że istnieje obowiązek przekazywania książek do wybranych bibliotek i te naprawdę niskonakładowe (do 100 egzemplarzy) są - no, powinny - być dostępny w Bibliotece Narodowej w Warszawie i Bibliotece Jagiellońskiej w Krakowie, a te o większym nakładzie w kilkunastu innych bibliotekach rozsianych po całym kraju. Chciałbym być pewnym, że te zbiory przetrwają jeszcze wiele lat, ale jeśli właściciele AI wykupią zdecydowaną większość książek to zdobycie jednego tytułu może stać się zadaniem naprawdę trudnym, gdzie albo zapłacimy za unikat duże pieniadze bądź też będziemy musieli planować wyprawę do stolicy lub Krakowa, by przeczytać lub sfotografować potrzebny tytuł. I to wbrew pozorom jest bardzo poważny problem, którego pierwszymi ofiarami będą chociażby naukowcy, którym sprząta się sprzed nosa literaturę specjalistyczną, drukowaną w bardzo małym nakładzie.

Ciekawe czy ładują jak leci, czy robią jakąś selekcję? Np. książkę akwarelisty zeskanują, czy nie?
@Millionth_Visitor Pewnie nikt nie przejmuje się, jakie tytuły idą do bazy, kto miałby się przejmować weryfikacją, jak każdemu zależy na szybkim tempie? A co do "Mein Kampf" to na 100% trafiła do bazy, jeśli nie w oryginalnym wydaniu to chociażby w edycji krytycznej, którą możesz kupić legalnie w dobrze zaopatrzonej księgarni.
@roadie a potem nie będzie starych wydan książek i będzie jak u orwela że będą nam kontrolować historie
Zaloguj się aby komentować