
Ciekawa sprawa: Pojawił się nowy silnik do najnowszego modelu Qwen3.8-flash-next .
Strata, bo taką nazwę nosi ten silnik ma zaskakująco niskie wymagania:
W miarę nowe 12GB GPU na PCIEx16, 64GB RAM, szybki SSD
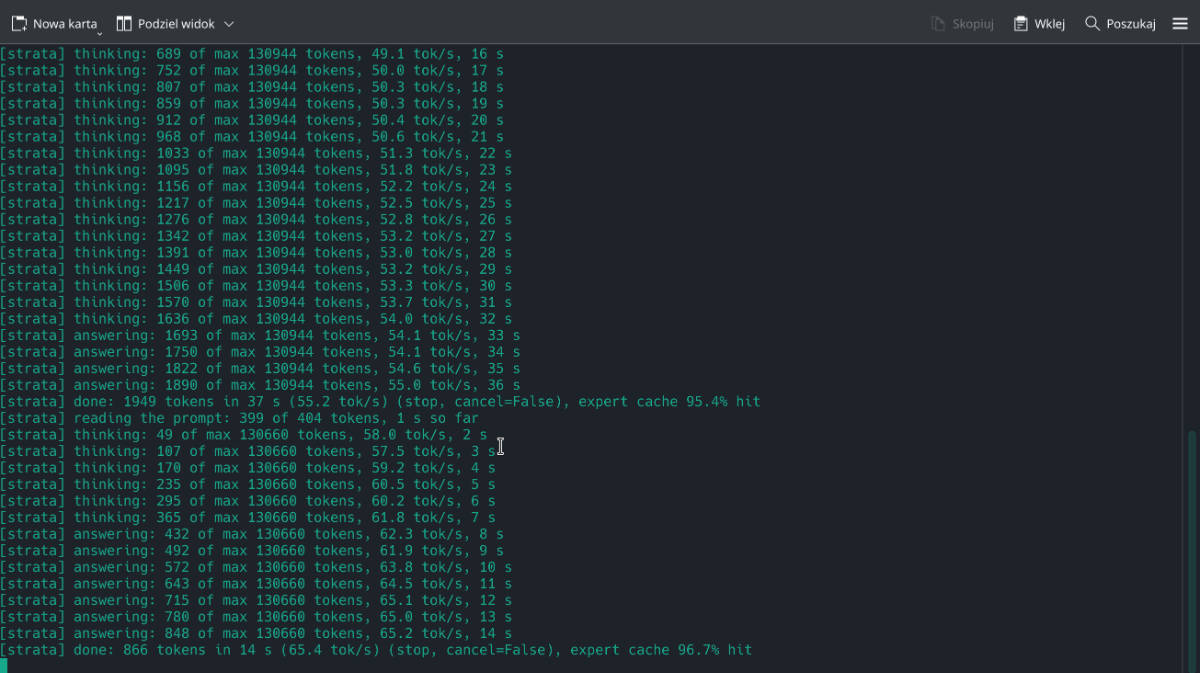
I teraz bomba: Ten model ma 120 miliardów parametrów. Ponieważ to MoE (mixture of experts), typ który rozwija ten silnik wrzucił najczęściej używanych ekspertów do GPU, a resztę do RAMu, do tego jest dodatkowy model przewidujący trzy kolejne słowa do przodu - silnik ładuje ekspertów do GPU z wyprzedzeniem. dzięki czemu model działa szybko. Mówimy tutaj o ~40tok/s.
Na Screenie mocno wykastrowana wersja modelu zmieszczona na styk w 24GB GPU i 32GB RAM
EDIT: Ważna sprawa, traktujcie to jako wczesną betę. Koleś nie dokończył jeszcze obsługi API zgodnego z OpenAI, więc na razie to jest zabawka a nie praktyczne narzędzie.
#ai #llm #selfhosted #programowanie #sztucznainteligencja