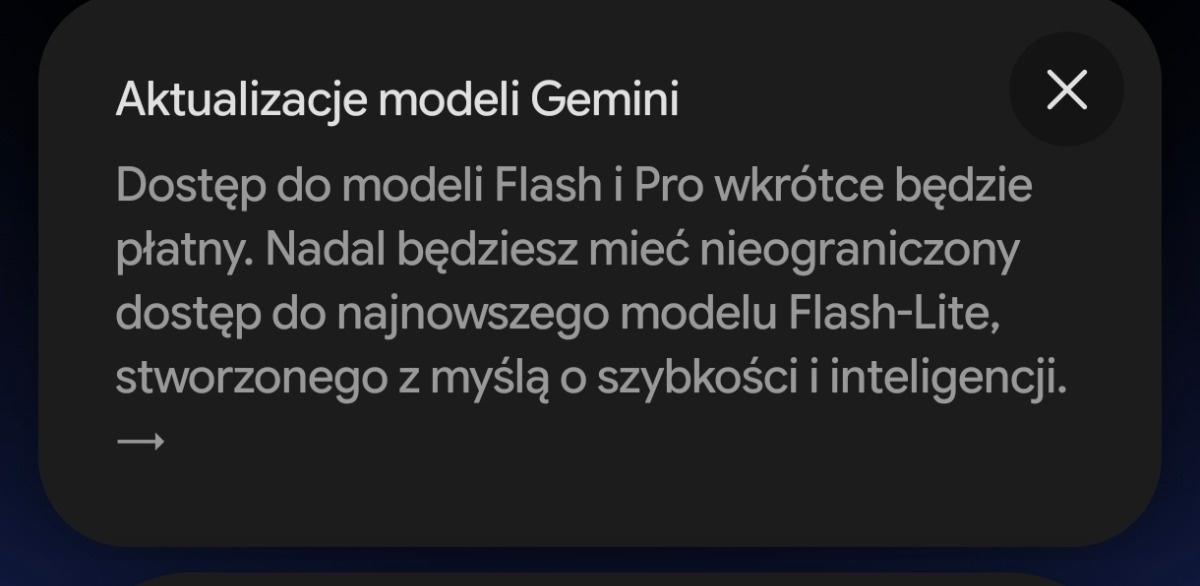
Dobra, skończyła się moja boska cierpliwość. Wyrzucam to zklładzione gówno na śmietnik historii i słucham państwa. Tym razem rady typu
no poczekam jeszczem już jeszcze chwila
uznaje za sabotaż.
Zastanawiam się nad kupieniem 4 klocków od nvidia. Tych sparkowych. Jednakże z drugiej strony chyba taniej wyjdzie rack na GPU z jakimkolwiek VRAMem, który da się podłączyć w council. Nawet chińskie karty graficzne zaczynają mi się podobać.
To już za dużo, żebym k⁎⁎wa płacił łysemu altmanowi z dildem Trumpa w d⁎⁎ie za to, żeby móc sobie zrobić sideproject bez bycia oskarżąnym o terroryzm.
Strix Halo - mam póki co jedno mini pc bo ceny są póki co dramatyczne. Mini PC od appla tez sobie dobrze radzi, szczególnie jak sie wrzuci Splash - moj znajomek sobie hostuje i sobie chwali
Kiedyś cieszyłem się jak youtube polecał mi jakiś niszowy zespół, mnóstwo świetnych zespołów znalazłem w ten sposób. Od czasu jak jest ai nie klikam w miniaturki zespołów których nie znam i nazwy nigdy nie słyszałem. Smutne to.
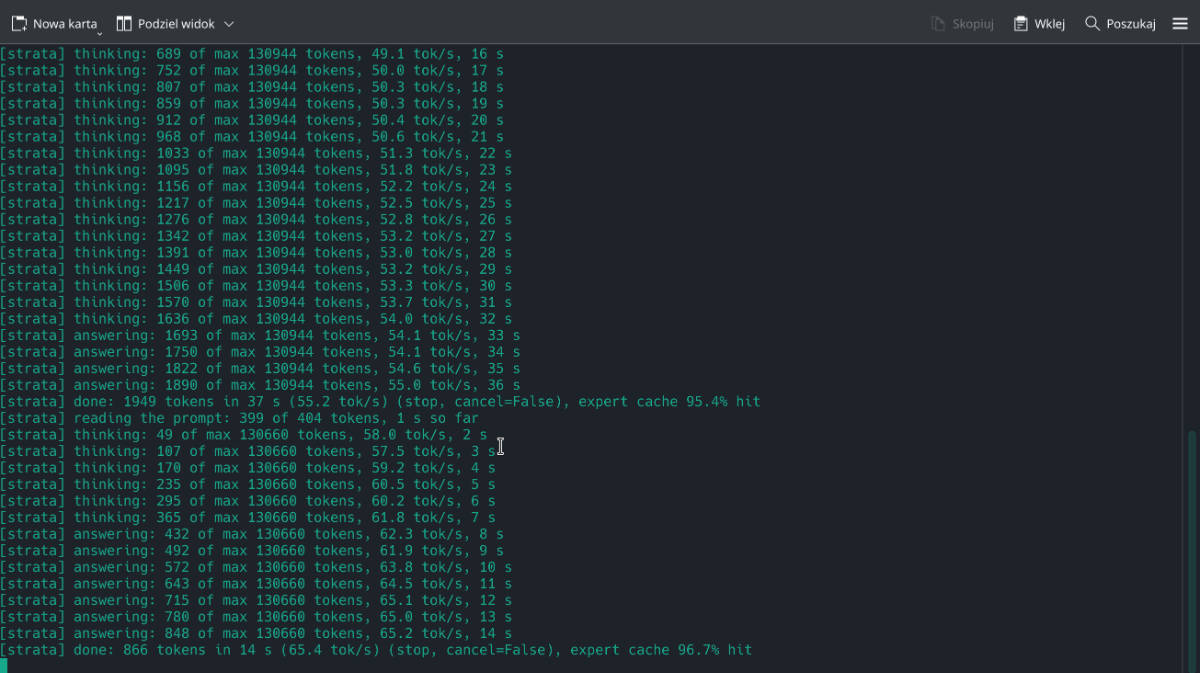
Strata, bo taką nazwę nosi ten silnik ma zaskakująco niskie wymagania:
W miarę nowe 12GB GPU na PCIEx16, 64GB RAM, szybki SSD
I teraz bomba: Ten model ma 120 miliardów parametrów. Ponieważ to MoE (mixture of experts), typ który rozwija ten silnik wrzucił najczęściej używanych ekspertów do GPU, a resztę do RAMu, do tego jest dodatkowy model przewidujący trzy kolejne słowa do przodu - silnik ładuje ekspertów do GPU z wyprzedzeniem. dzięki czemu model działa szybko. Mówimy tutaj o ~40tok/s.
Na Screenie mocno wykastrowana wersja modelu zmieszczona na styk w 24GB GPU i 32GB RAM
EDIT: Ważna sprawa, traktujcie to jako wczesną betę. Koleś nie dokończył jeszcze obsługi API zgodnego z OpenAI, więc na razie to jest zabawka a nie praktyczne narzędzie.
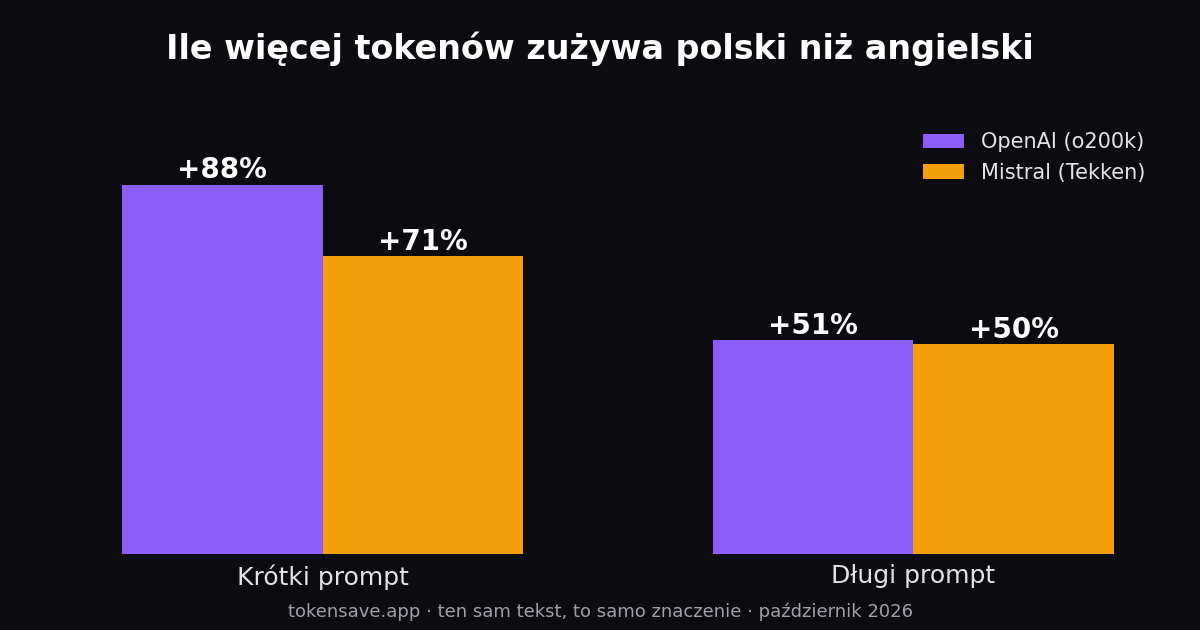
Zmierzyłem, ile tokenów „zjada” polski w modelach AI. Ten sam prompt o identycznym znaczeniu:
krótki (2 zdania): 34 tokeny po angielsku vs 64 po polsku (+88%)
długi (~100 słów): 110 vs 166 (+51%)
U Mistrala bardzo podobnie (+71% / +50%), więc „europejski” model nie pomaga. Winne są końcówki fleksyjne: „potwierdzenie” to dla tokenizera pot|wier|d|zenie, „zaproponuj” to zap|ro|pon|uj, a angielskie „invoice” czy „polite” to jeden token.
W praktyce w API płacimy za ten sam tekst nawet prawie 2× więcej, a w ChatGPT Plus / Claude Pro limit kończy się szybciej.
Trik: piszcie dłuższe instrukcje po angielsku i dodajcie na końcu „Reply in Polish”. Odpowiedź dalej przychodzi po polsku, a wejście jest krótsze o 31–41%.
Zauważyłem że nie zawsze potrafię dokładnie opisać co mam na myśli pisząc prompta po angielsku, szczególnie jeśli temat jest zawiły i sam mam braki w wiedzy, bo jestem na początku procesu. Czasami pomylę czas i to kompletnie zmienia sens zdania, które napisałem (i nie mówię o present simple tylko tych zawiłych czasach które nie mają odpowiedników w j polskim a w szkołach najmniej się o nich mówi). No i wreszcie pisanie prompta powinno być dość szybkie, a nie że siedzisz i się zastanawiasz przez 5 minut jak to zredagować (od tego jest AI przecież xd). Z tego powodu i tak piszę prompty po polsku, przynajmniej dopóki nie osiągnę biegłości w j angielskim bliskiej j polskiego :p
@tokensave czy to nie jest kwestia tego, że polskie wejście jest mapowane na angielski gdzieś tam pod spodem?
Generalnie z tego co mi kiedyś ktoś tłumaczył, to pod spodem i tak to działa na całych słowach, a nie sylabach, więc polskie "faktura", "fakturka", "faktury" i angielskie "invoice" są dla modelu tożsame. Się nie znam tylko powtarzam z pamięci.
Nie było nigdy tak łatwo uruchomić webserwis, usługę webową wraz z pełną ofertą i pod kompletną marką z wszystkimi elementami wizerunku. Wysyp vibe codowanych startupów, demo produktów - na przykładzie serwisu do analizy umów opisuję jak to jest też ryzykowne i pociągające do odpowiedzialności wyzwanie.
Z drugiej strony: czy to nie jest honey pot czyli źródło przyciągające ludzi do zostawiania ważnych dokumentów?
@ostrynacienkim Odwrotnie, przestrzega. Jest masa problemów które można przyciągnąć. Zapełniam sobie webserwis informacyjny który chcę uruchomić i jeb maile od Polki ze Szwajcarii, że użyto zdjęć Associated Press, Reutersa i wezwania do zapłaty Takich bzdur trzeba nawet pilnować okazuje sie, prawo cytatu nie działa, oznaczenie autora też nie.
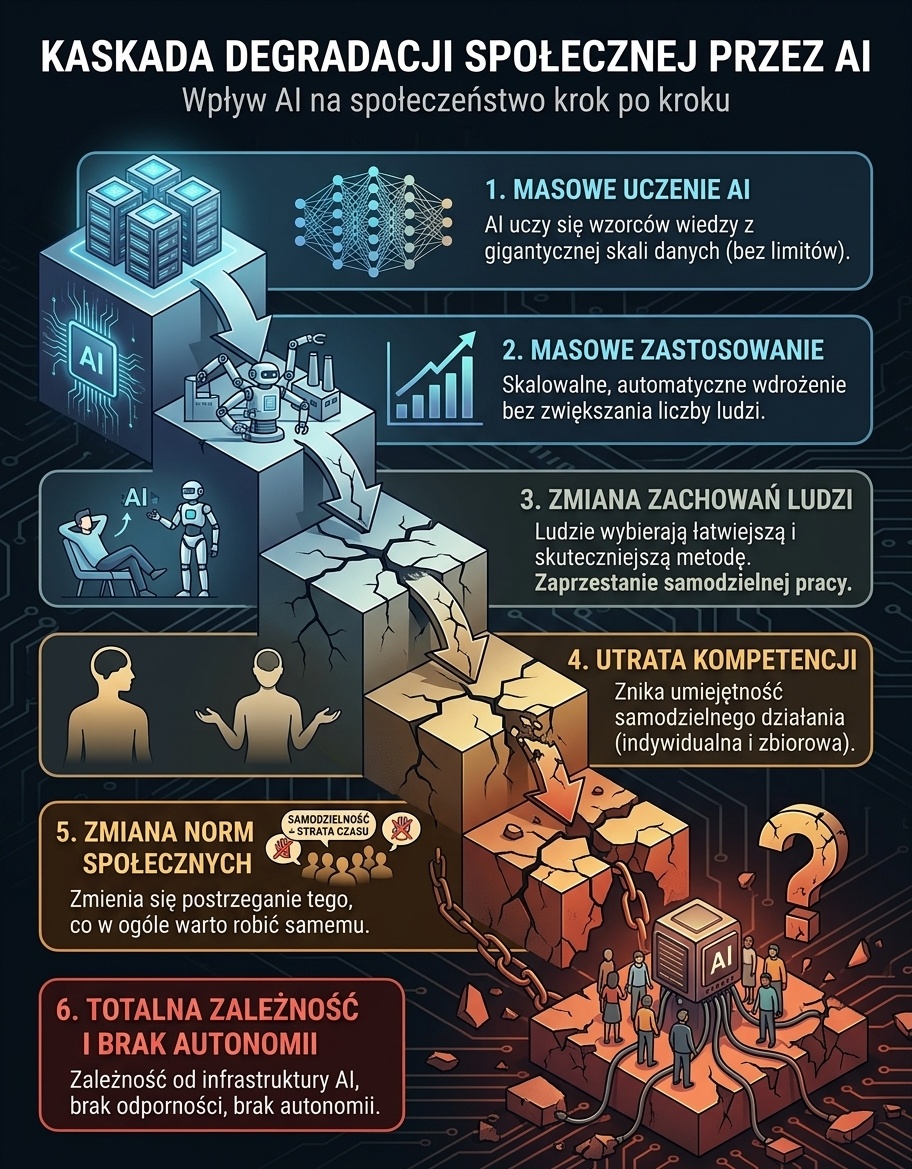
@O.o Tak, i pytanie, czy warto z tym w ogóle walczyć, czy tylko to opodatkować i niech ludzie z rent żyją i wymyślają sobie zajęcie sami... I jaka podstawa do tego, poza samym "bo ludzie nie mają za co żyć". To że nastąpiła swego rodzaju kradzież dorobku historycznego ludzkich umiejętności, wiedzy i kultury przez AI jest wystarczającą podstawą?
@fewtoast to nie jest śmieszne nic a nic. W mojej grupie znajomych z IT praktycznie nikt już nie klepie kraftowego kodu. Kiedyś przy piwie gadaliśmy o jakiś libkach, nowych frameworkach itd. Teraz każdy gada tylko o agentach, skillach, modelach. Powodzenia w powrocie klepania w klawiaturę po 8h gdy ta cała bańka w końcu padnie na ryj.
@lipa13 To jest pytanie, czy warto się tym przejmować w ogóle, czy płynąć z falą i jakoś to będzie? Gdy dojdzie do tego, że robiące wszystko co ci potrzebne AI odpalisz na małym i tanim urządzeniu lokalnym offline, to jeszcze to przejdzie, ale jak nie, to te uzależnienie od centrali jest dużym problemem. Ja wierzę, że to pójdzie, będą optymalizacje modeli, nowe hiper wydajne chipy. Zostanie wtedy ta część - całkiem duża - po prostu wytwarzania dóbr, dostępu do zasobów, że to nie tak że każdy będzie miał swoją armię robotów i zasoby z którym będą one wytwarzały potrzebne dobra.